为什么我们总爱把文化做成一道有标准答案的题?
如果你平时刷短视频,大概率在信息流里撞见过那种街头突击采访。 商场门口,收音麦克风冷不丁戳到鼻尖前,镜头后面是一双期待“穿帮”的眼睛:“请问,‘飞流直下三千尺’,下一句是什么?”被拦住的年轻人愣了三秒,瞳孔微缩,大脑在早八的咖啡因与昨夜的疲惫间当场宕机。镜头切走,评论区立刻万头攒动、摇头叹气:“九年义务教育算是喂了狗”、“国学式微,真是一代不如一代”;可若是他顺口接出了“疑是银河落九天”,弹幕里又瞬间涌出千百条“腹有诗书气自华”。 三秒钟,立地成佛,或者当场问斩。一个活生生的人有没有文化,被折叠成了一张两块钱的即开型刮刮乐。 我总疑心这种场面带着点荒诞。倒不是李白的诗不该背,也不是历史年份、古训通假皆可抛;真正叫人玩味的,是那股迫不及待的“判卷瘾”:最好世界只有一个答案,最好三秒之内胜负立判,最好连蹲在马桶上刷手机的闲人,也能顺手拿起一支红笔。 汪洋浩瀚的文化,到头来被榨干成了一句逼仄的口令:“下一句是什么?” 一、浅水区的判卷权:为什么街头文化永远停在中小学?只要耐着性子多看几十条这类街头文化大考,就会发现街头考官的题库水位,向来恒定得有些滑稽。 翻来覆去考的,永远是小学的李杜...
当代码越来越便宜,为什么架构反而越来越贵?
这两年,每当有老程序员对着屏幕抱怨 AI 写出来的代码越来越像一锅让人犯高血压的泔水时,酒桌上总有人喜欢搬出当年围棋界的 AlphaGo 来堵他的嘴。 这套辩词听上去还真挺能唬人。当年 AlphaGo 走出那手石破天惊的“第 37 手”时,全世界的人类九段国手第一眼看过去也全都皱起眉头,怀疑机器是不是出了故障,因为那一步棋在传统棋理里实在太难看了;可等几十手棋走完回过头再复盘,人们才羞愧地发现,根本不是机器不会下棋,而是人类自己算不出五十步以后的变化。 于是,一模一样的故事被顺理成章地搬到了今天的软件工程里。你让一个编程智能体去改个芝麻大的小功能,它倒好,凭空给你新建两个辅助函数,外面套上三层包装器,把仓库里原本就写好的现成逻辑原封不动地重新实现一遍,最后在对话框里一本正经地向你邀功:“任务已成功完成。”人类工程师看完气得想砸键盘,可旁边的拥趸马上就会反问一句:你怎么知道这是烂代码?有没有可能,只是你脑容量太小、看不懂机器的高维智慧? 顺着这个逻辑往下推,场面就更让人心安理得了:过去我们之所以在“古法编程”时代死抠代码美学,甚至觉得程序员骨子里是个讲究起承转合的文科生,无非是因为...
我们真的在领跑 AI 吗?我们的“母机”在哪里?
这几年科技圈里流行着一种特别省脑子的说法:大模型时代已经打成了中美两强决赛,至于欧洲和日本,差不多已经买好站票退居观众席了。 这种感觉当然不是凭空捏造出来的。你把今天全球最有声量的大模型名单在桌子上摊开,大洋彼岸有 OpenAI、Google、Anthropic 和 Meta,我们这边有 DeepSeek、千问和豆包,而偌大一个欧洲,真正还能挤进全球通用大模型牌桌中央被人念叨的名字,翻来覆去好像只剩下一个 Mistral。于是,整张 AI 时代的全球权力地图,很快就被简化成了一幅特别适合在短视频里三秒钟讲完的漫画:美国在左,中国在右,欧洲只配起草监管法案,日本埋头拧机器人螺丝,其余国家负责在场边鼓掌。 这张地图最大的好处是让人看着痛快,最大的毛病也是痛快得过了头。 假如生成式 AI 到头来只是一场火力更猛的移动互联网平台战争,那比拼模型跑分、算力卡数、日活用户量和开发者生态,确实就已经足够定下输赢了。谁家的聊天机器人更机灵,谁占住了更多人的手机屏幕入口,谁手里攥着更大的云和更多的应用开发者,谁自然就是当之无愧的霸主。可只要我们还承认嘴里天天挂着的那句“AI 是下一次工业革命”不是...
同样月入一万五,为什么敢休周末的人才是中产?
有一年逢着中秋节放假,身边有个刚从校园步入社会的年轻人看着手机屏幕,冷不丁问了一句看似天真的话:“既然中秋是国家法定节假日,为什么街上还有这么多外卖可以点,楼下的便利店和物业也还在上班?” 这个问题听起来近乎幼稚,却一下子戳破了不同人群对“节假日”截然不同的默认想象。 在长达十几年的学生时代里,我们住在一个由课表和校历严密统治的世界:到了周六周日,教学楼理所当然地熄灯;到了法定节假日和寒暑假,全校师生顺理成章地放假回家。站在讲台上的老师们,虽然平时备课、带班、改卷子忙得团团转,但只要寒暑假的大门一关,哪怕两个月不上课,哪怕刨去与课时挂钩的浮动绩效,基本工资和社保依然按月到账。在校园或者机关大院里待久了,人很容易产生一种“日历幻灭”前的错觉,以为“逢年过节全社会一起停转”是人类社会的出厂设置。 所以每逢节假日调休方案公布,或者网上又掀起“双休到底能不能全面落实”的讨论,社交平台上的争吵总是格外激烈。在热搜和评论区里,周末双休与黄金周长假几乎被默认成了一项天然属于全体劳动者的普世福利。 可一旦把目光从校园、机关大院和写字楼移开,往街对面的餐馆、便利店、网约车驾驶座和电动车后备箱看一眼...
为什么“背字典学写作文”早成了笑话,背单词却成了英语第一神教?
很多人大概都对早年间的一类教育新闻有点印象:电视节目里请来一个几岁的小朋友,被称为“背字典神童”,主持人随便提一个冷僻生字,孩子不仅能立刻念出读音和组词,甚至能精准报出它在《新华字典》里的所在页码。 台下一片惊叹,镜头纷纷对准父母,赞扬这种超常的记忆力与刻苦。可如果今天有一位中学语文老师在讲台上认真建议大家:“想要把高考作文写好、想看懂深度社论,大家赶紧去把《新华字典》从第一页背到最后一页。”台下的学生大概率会觉得老师疯了。 中文学习里,大家到了初高中以后几乎天然形成了一种常识:写作和阅读靠的是大量输入、理解结构、观察现实、逻辑组织和观点表达,绝不可能靠背字典完成。如果一个人文章写得干瘪凌乱、言之无物,却硬往里面塞一堆从词典角落里抠出来的华丽生僻字,我们甚至会觉得这是一种很糟糕的“堆词”。 可奇怪的是,一旦场景切换到英语,这套在中文里被大家嘲笑的荒谬逻辑,却摇身一变成了无可争议的“唯一正途”。 书店里最畅销的永远是各种厚度的单词红宝书;手机里装得最多的永远是主打艾宾浩斯复习曲线的背词软件;朋友圈里最常见的永远是“已连续打卡 120 天,今日斩获 87 词”的分享海报;而在考研英语...
为什么你秒懂 LoRA,却背不出它的中文全称?
翻开 2021 年考研英语一的第一篇阅读理解,文章讲的是英国铁路票价上涨、铁路罢工、服务质量与政府补贴。 刚看前两段的时候,很多人最习惯的做法,是拿出一支荧光笔,把里面看起来不顺眼的词一个个挑出来查字典:票价叫 fare,通勤者叫 commuter,工会叫 union,罢工叫 industrial action,通胀叫 inflation,补贴叫 subsidise。等把十几个生词的中英文对照整整齐齐抄在笔记本边缘,再抬头看正文,脑子里依然是一团浆糊。 可如果换一种方式,先不急着去抠每一个陌生词条的标准中文释义,而是顺着认识的句子主干,在脑子里先搭出一个大体的情境:英国铁路又要涨价了,乘客很不爽;运营方和政府说维护老旧基础设施要花大钱;但乘客觉得票价一年比一年贵,车厢拥挤晚点不说,工会还动不动搞罢工导致全线瘫痪;最后文章开始探讨纳税人与乘客到底该谁来买单。 一旦这个公共政策与劳资博弈的场景在脑海里立起来,那些原本散落的生词就会像磁铁一样迅速吸附到各自的位置上。你再看到 commuter,根本不需要在心里念一句“通勤者”;看到 industrial action,也用不着去查为什么...
导师总让你先看五十篇论文,可为什么很多 Idea 根本不在论文里?
很多研究生刚进组的时候,都会收到一份极其相似的新手任务:先去找几十篇相关方向的论文下来精读,最好再看几篇长综述、翻两本往届师兄师姐的博硕学位论文,等看够了,再来组会上汇报自己的开题想法。 这套安排听起来非常正统,可真正做过一段时间项目和实验的人,心里往往会产生一种说不出来的别扭。 因为回看那些真正做成了的想法,它们最初冒出来的那一刻,很多时候根本不是在读第三十七篇 PDF 时突然灵光一闪,而是某天刷到一篇公众号解读、看到技术论坛里的一个争论、或者在 GitHub 上顺手跑了一个刚开源不久的项目。反倒是那些发表了好几年的论文和厚重的学位论文,翻开一看,里面的基座模型早就迭代了三轮,当年绕不过去的瓶颈今天可能已经被某个新算子顺手抹平了,有些甚至连代码仓库都跑不通。 于是,一个很自然的疑问就会浮出来:既然真正新鲜的想法常常来自公众号、社区和开源项目,为什么导师还是总让大家先去啃几十篇论文? 想通这个问题之后就会发现,矛盾并不在于“看论文”这件事本身是错的,而在于很多人把“看论文”默认等同成了“科研的 Idea 必须从论文里长出来”。 这两件事,其实根本不是一回事。 一、传播时差:当一篇...
先挂个 arXiv 占坑,到底占住了什么?
每次手里的实验陆续跑完、论文初稿慢慢收拢成型的时候,很多人脑子里都会冒出一个特别世俗的念头:要不要赶紧先把文章挂上 arXiv,占个坑再说? 这种冲动在今天的大模型和 AI 安全圈子里太常见了。同一个细分问题,你可能刚把基线跑通,顺手搜一下文献,就看到某个课题组刚刚放出了一篇思路相近的预印本;如果论文一直锁在本地文件夹里,除了合作者之外,没有任何人知道你做过这段探索;可如果现在就公开,心里又难免打鼓:万一后面正式投稿还要大改怎么办?万一有些扩展实验还不够完美怎么办? 仔细拆解这种纠结就会发现,最让人拧巴的地方,其实恰恰出在“占坑”这两个字上。 一旦用“占坑”来理解预印本,人就很容易走向两个极端:要么觉得不管质量怎么样,先把几页半成品扔上去抢个名字;要么觉得既然还算不上惊天动地的顶会级突破,挂出去也没什么意义。 可预印本从来就不是一张用来跑马圈地的“产权证”,而是一份把实验事实提前摆上台面的“研究账本”——它的核心不是宣告“这个方向归我了”,而是把一组已经做扎实、经得起复核的实验变成公开世界里可被检索、引用和持续迭代的坐标。 换一个词,事情的性质就全变了。 一、优先权错觉:抢到一个...
真正的动物翻译器,可能会诞生在具身智能之后
下一代 AI 的互联网,可能不在互联网里具身智能系列 · 第 06 篇(终章) 人类一直很想知道动物在说什么。 动画片给过我们一个很舒服的答案:猫和狗其实也会说完整的话,只不过人听见的都是“喵”和“汪”。于是所谓动物翻译器,似乎只缺一本隐藏的词典,这一声代表饿,另一声代表害怕,再一声代表:“你昨天为什么这么晚回来?” 这个想象很浪漫,也非常人类。 因为我们自己高度依赖语言,于是很容易认为,复杂智能背后大概都应该藏着一套类似语言的东西。 可真正的 Animal Translator,也许根本不是翻译一句话。 一、一只美国猫和一只中国猫,并不会先学外语一只纽约长大的猫碰见一只上海长大的猫,不会先遇到英语和汉语之间那种障碍。 猫会读姿态、尾巴、耳朵、距离、声音和气味。一只猫弓背、炸毛、哈气,另一只并不需要字幕。 所以动物当然有大量物种层面的交流信号。 但“能够通信”不等于“拥有和人类一样的开放语言”。 TCP 也能通信。 只是不会写诗。 动物的大量交流可能更多是在表达接近、回避、警戒、亲近、威胁、身份和协调。这些已经足够复杂,只是不一定能整齐地切成一句句中文。 二、真正的动物翻译器...
一只宠物项圈,会不会成为具身智能时代的数据入口?
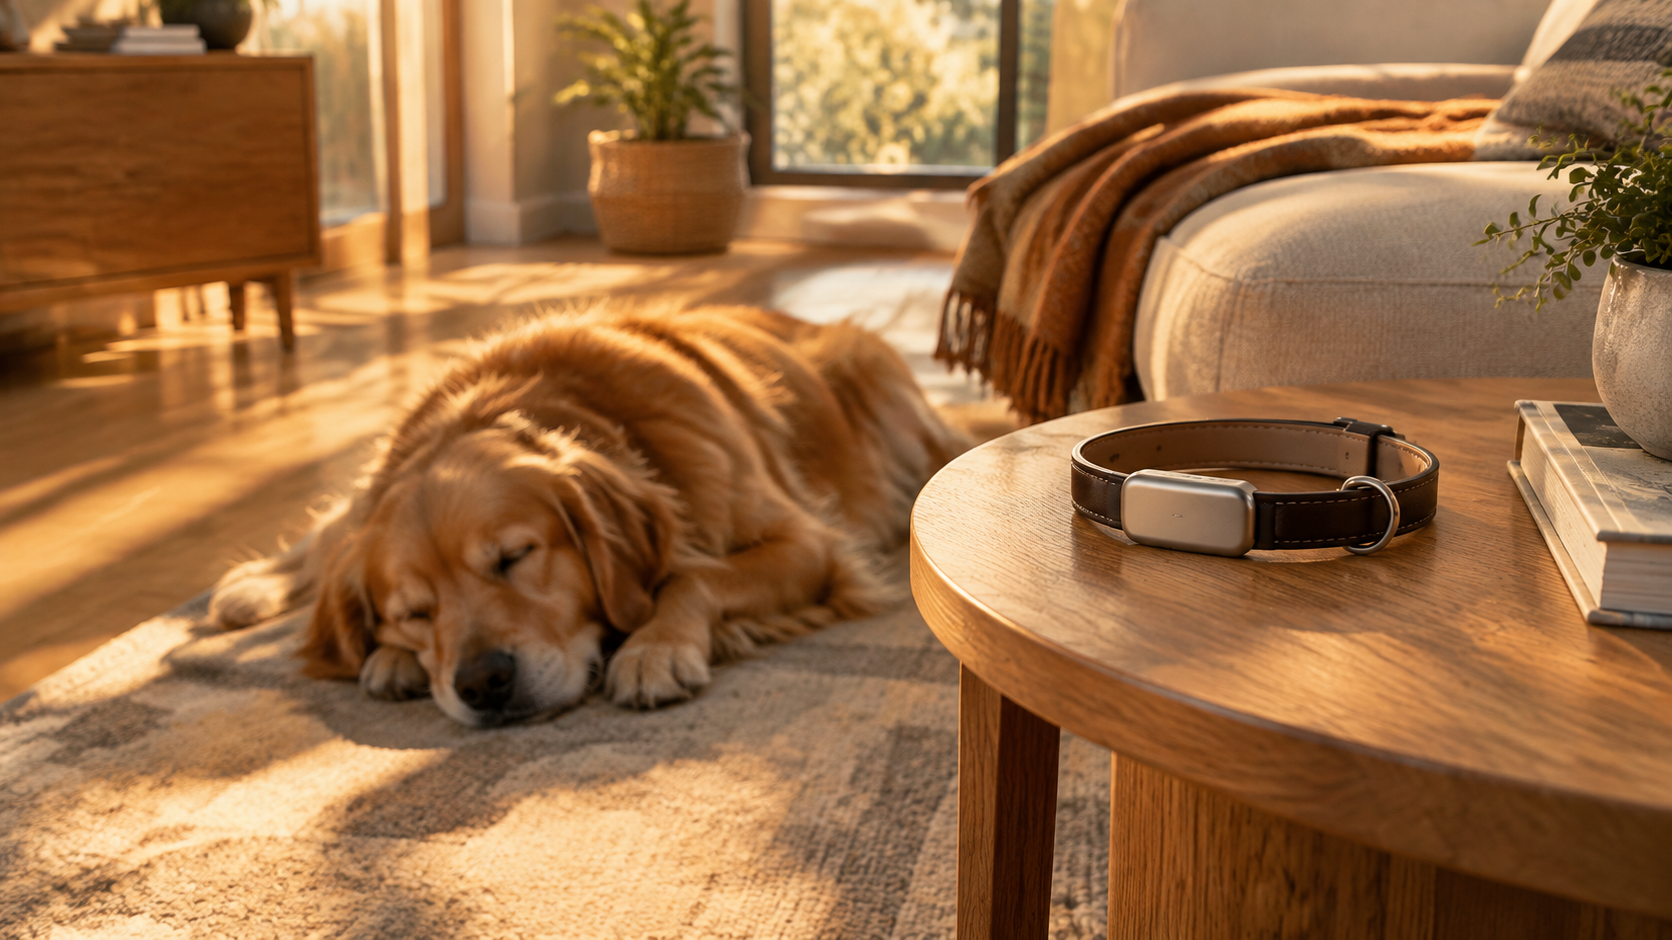
下一代 AI 的互联网,可能不在互联网里具身智能系列 · 第 05 篇 如果你告诉一个普通宠物主人: “请每天给这个设备充电,因为我们想建立 Animal Foundation Model。” 大概没人理你。 但如果你告诉他,这个设备可以帮助防走失、记录活动、发现健康异常,甚至越来越懂他家这只具体的狗,事情就完全不一样。 这个区别看起来很普通,其实正是互联网时代大规模数据最重要的秘密之一: 真正廉价的数据,往往不是因为有人想生产数据才出现,而是因为有人本来就在做另一件有价值的事情。 一、好的数据入口,首先不能只是“数据入口”Google 搜索首先解决的是搜索问题。 智能手表首先解决时间、运动和健康问题。 汽车首先解决出行问题。 数据是在产品真正被使用以后自然留下来的。 宠物设备如果真有机会形成大规模长期数据,也必须遵循同一条规律。 用户首先购买的是防走失、健康和行为理解,而不是“给未来机器人贡献训练数据”。 所以宠物项圈真正有意思的地方,不是项圈本身多先进,而是: 一个有独立消费价值的设备,能不能让过去很难大规模得到的长期具身数据自然积累起来。 二、真正有价值的 AI,也...