现实世界已经被拍了几十年,为什么机器人还是缺数据?
下一代 AI 的互联网,可能不在互联网里
具身智能系列 · 第 02 篇
如果你在一座现代城市里走上一天,会遇到一个很奇怪的矛盾。
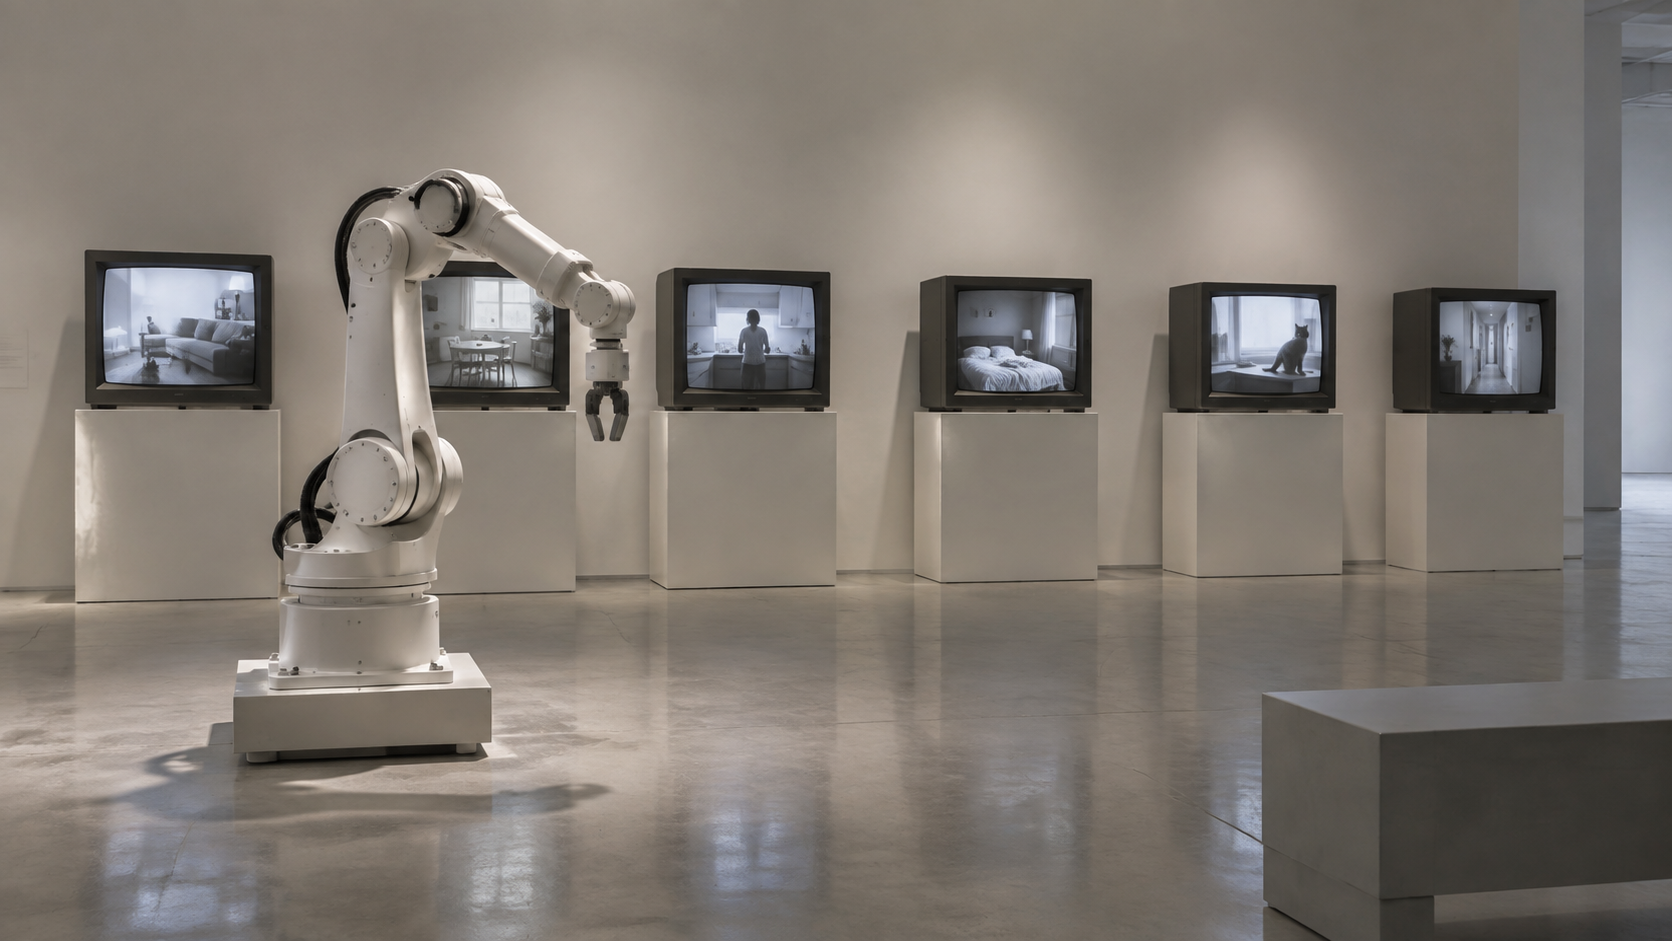
一边是具身智能公司不断说机器人数据太少,另一边却是摄像头多得让人觉得,我们的人生大概已经被拍得差不多了。道路、停车场、工厂、商场、仓库、电梯里都有摄像头,汽车自己又装了一圈传感器,普通人还有手机、运动相机、无人机和越来越多的智能眼镜。
世界显然不缺画面。
所以真正的问题不应该是“现实数据在哪里”,而应该反过来问:既然现实已经被拍了这么多年,为什么这些东西没有自然变成机器人的互联网?
因为“世界曾经被记录过”和“世界已经变成训练语料”,从来不是同一件事。
一、短视频和监控,记录的是两种不同的现实
互联网视频有一个很明显的偏差:它拍的是人觉得值得拍的东西。
一顿饭吃两个小时,最后剪成三十秒;旅行八个小时都在坐车,视频里留下的是日落;一只杯子在桌上静静放三个小时,几乎不会有人觉得这是值得上传的内容。互联网视频因此并不是现实的均匀采样,而是一份经过人类注意力筛选以后留下来的世界。
监控恰好相反。
它最大的特点,是无聊。
墙在那里,昨天在那里,今天还在那里;一个箱子半天没有动,一个人从走廊一边走到另一边,一辆汽车每天重复经过同一个路口。对于短视频平台,这些内容几乎没有价值,可对于 World Model 来说,它们反而记录了一个很重要的事实:世界的大部分时候,并没有发生戏剧性的事情。
物体不会凭空消失,被遮挡以后通常仍然存在,一个人从门里走进去以后不会下一帧突然出现在屋顶。所谓物理常识,大量建立在这种“世界保持连续”的无聊之中。
所以可以这样说:
短视频记录的是人觉得值得看的世界,监控记录的是世界本来怎样连续运行。
两者都是视频,却可能教会模型完全不同的东西。
二、可是监控终究只是一个旁观者
问题也恰恰出在这里。
一个固定摄像头可以看见一万人如何绕开障碍,却从来没有自己绕过一次障碍;可以看见工人打开抽屉,却不知道手指到底用了多少力;可以看见一个杯子被拿起来,却未必知道那只手是不是在最后一刻差点打滑。
所以监控数据最擅长教给机器的,是空间、对象、轨迹、人群和事件,是世界怎样连续变化,而不是真正的身体控制。
这就是为什么“城市有海量 CCTV”和“机器人仍然缺数据”并不矛盾。
机器人真正稀缺的往往不是别人看起来是怎么做的,而是:
我自己做了什么以后,世界会发生什么。
三、车载数据为什么特别不一样
汽车比普通监控多走了一步,因为它不仅看世界,自己也在行动。
如果一段车载数据同时记录摄像头画面、速度、方向盘、刹车和车辆状态,那么模型得到的就不再是“前方出现行人,后来车慢了下来”,而是“在这样的环境里,车辆采取了这样的控制,然后发生了这样的结果”。
Observation 和 Action 第一次天然地绑在一起。
也正因为如此,自动驾驶很容易形成所谓的数据飞轮。车辆本来就是产品,用户本来就要开车,车里也本来就有电源、计算设备和传感器,数据生产不需要另外雇一个人“表演驾驶”。
但这里特别容易产生一种商业上的偷换:Tesla 能形成数据闭环,并不意味着所有现实产品都天然有数据闭环。
汽车只是条件特别好的一个特例。
四、数据飞轮没有 PPT 里那么圆
“产品带来用户,用户产生数据,数据改善模型,模型改善产品”,是一张非常好画的图。画完以后,几乎什么行业看起来都有飞轮。
现实没有这么配合。
产品如果一年只用两次,没有规模;采到的数据如果和最终模型要学的东西关系很弱,没有价值;数据如果不能合法二次利用,没有飞轮;模型变强以后如果产品体验没有明显改善,同样不会带来更多用户。
所以“副产品数据”真正成立,需要产品使用频率、数据相关性、合规条件和反馈价值同时成立。
商场老板安装监控是为了安防,他没有义务为了机器人行业给摄像头增加传感器,再替 AI 公司保存五年录像。
数据顺便产生,确实很便宜;为了数据重新改造整个产品,成本就又回来了。
五、现实世界每天都在被拍,也每天都在被遗忘
视频还有一个比文本残酷得多的问题:太大。
一页网页可以在硬盘里躺很多年,连续高清视频却很快占满空间,所以现实中的监控不会永久积累,而是根据成本、用途和法规不断覆盖。
于是每天都有一件很荒诞的事情发生:
摄像头不断记录世界,硬盘不断删除昨天。
世界被拍下来,又被硬盘自动遗忘。
十年前一篇无人问津的博客,今天也许还能在搜索引擎里找到;十年前某个工厂里,一个人第一次抓取失败以后怎样调整,那段录像可能早已彻底消失。
所以:
世界产生过数据,不等于世界积累了数据资产。
六、拍到别人,也不等于拥有别人
然后还有一个比硬盘更难的问题:隐私。
安防摄像头为了安全而安装,并不等于画面里所有人都自动同意把自己的脸、行为轨迹和日常生活拿去训练商业基础模型。
所以 Physical Common Crawl 从一开始就不可能简单复制网页爬虫。互联网主要问“能不能抓到”,物理世界还必须问:“为什么你有权使用?”
这会逼迫未来的数据系统尽可能在源头就进行处理。模型真正需要的,也许只是“一个移动 Agent 在狭窄走廊里如何避让另一个 Agent”,并不需要知道这个人是谁、几点下班、住在哪里。
真正成熟的物理数据系统,应该尽可能:
留下有用的世界结构,而不是留下不必要的人的生活。
七、我们其实只是把“可见光世界”拍了很多遍
还有一个更深的问题。
摄像头很多,不意味着现实已经被数字化。我们只是把某一种模态记录得特别多而已。
视觉。
可是机器人真正进入现实以后,很快会发现,这个世界不只是“看起来怎样”,还包括有多滑、多软、多重、温度如何、表面怎样振动、空气里有什么、接触以后材料如何变化。
这些数据在人类历史里少得可怜,因为过去没有人会把自己握杯子时的指尖压力上传到互联网。
所以互联网一方面给 AI 留下了巨大的视觉遗产,另一方面也留下了巨大的 Sensor Debt。
我们拥有很多眼睛,却几乎没有留下世界被触摸时发生的事情。
八、我们缺的不是摄像头,而是炼油厂
所以现实已经被拍了几十年,机器人仍然缺数据,不是因为这些录像没有价值,而是因为它们距离真正可训练的具身经验还隔着很多层东西。
需要筛选。
需要压缩。
需要隐私处理。
需要把第三视角和第一视角对齐。
需要补 Action。
需要补视觉从来没有记录过的模态。
从这个角度看,摄像头只是油井,视频只是原油。
真正缺少的是:
现实世界的数据炼油厂。
思考与探讨
如果在家里装满摄像头,你觉得这些海量的居家日常录像,真能直接拿来训练出一台会做家务的机器人吗?欢迎在评论区分享你的观点。
本文收录于《具身智能:物理世界的下一代互联网》系列专栏(第 2 篇 / 共 6 篇)。